Представьте ситуацию: у вас есть CRM с контактами, таблица в Excel с продажами за прошлый год и база данных сайта с логами посещений. Вы хотите узнать, сколько денег принес каждый рекламный канал. Звучит просто? На практике вы тратите часы на копирование, удаление дублей и исправление ошибок в датах. Это боль большинства аналитиков и владельцев бизнеса. Проблема не в отсутствии данных, а в их хаосе.
Нормализация данных - это не просто модное слово из учебников по информатике. Это способ навести порядок в этом хаосе перед тем, как сложить все в единое хранилище. Но здесь кроется ловушка: то, что идеально для одной системы, может убить производительность другой. В этой статье мы разберем, как правильно готовить данные к интеграции, чтобы ваш отчет открывался за секунды, а не за вечность.
Почему нормализация нужна до загрузки в хранилище
Многие новички путают два процесса: нормализацию (упорядочивание структуры) и очистку (исправление ошибок). Давайте сразу расставим точки над «i». Нормализация базы данных - это процесс организации таблиц так, чтобы избежать дублирования информации и обеспечить целостность связей. Если вы попытаетесь загрузить «сырые» данные прямо в аналитическое хранилище без предварительной обработки, вы получите кашу.
Зачем это нужно на этапе подготовки? Представьте, что имя клиента написано в трех разных источниках как «Иванов И.», «Ivanov Ivan» и «Иван Иван». Без нормализации справочников эти записи будут считаться разными людьми. Ваша статистика будет искажена. Нормализация помогает создать единые ключи (например, уникальный ID клиента), по которым можно связать данные из разных систем.
Однако важно понимать контекст. Операционные базы данных (те, где ведется текущая работа, например, 1С или CRM) должны быть жестко нормализованы. Это защищает от ошибок при внесении изменений. Хранилище данных (DWH) работает иначе. Его цель - быстрый ответ на сложные вопросы («Какая категория товаров была самой прибыльной в каждом регионе за последние 3 года?»). Для таких запросов полная нормализация часто вредна.
ETL-процесс: мост между хаосом и порядком
Чтобы свести источники в одно хранилище, используется процесс ETL (Extract, Transform, Load). Это конвейер, который берет данные из разных мест, приводит их к общему знаменателю и кладет в финальное место хранения.
- Извлечение (Extract): Мы забираем сырые данные из CRM, ERP, логов сервера и внешних API. Здесь ничего не меняем, только копируем.
- Преобразование (Transform): Самый важный этап. Именно здесь происходит нормализация справочников, приведение форматов дат к единому виду (ISO 8601), устранение опечаток и объединение дублей. Например, если в одном источнике пол указан как «М/Ж», а в другом как «Male/Female», на этом этапе мы приводим всё к коду «M/F».
- Загрузка (Load): Готовые, чистые данные пишутся в таблицы хранилища.
Ошибка многих проектов в том, что они пропускают этап трансформации или делают его недостаточно глубоко. Они пытаются нормализовать уже загруженные данные внутри хранилища. Это дорого и медленно. Лучше один раз качественно очистить данные в процессе ETL, чем постоянно чинить аналитические отчеты.
Дилемма: Схема «Звезда» против полной нормализации
Вот тут начинается самое интересное. В операционных системах мы стремимся к третьей нормальной форме (3НФ). Это значит, что каждая таблица содержит информацию об одном объекте, и нет транзитивных зависимостей. Например, в таблице «Заказы» не должно быть адреса доставки, если он меняется вместе с клиентом. Адрес должен лежать в таблице «Клиенты», а в заказах быть только ссылка на клиента.
Но в хранилище данных такой подход часто приводит к катастрофически медленным запросам. Почему? Потому что для получения простого отчета базе данных приходится делать десятки операций JOIN (соединения таблиц). Чем больше соединений, тем выше нагрузка на процессор и память.
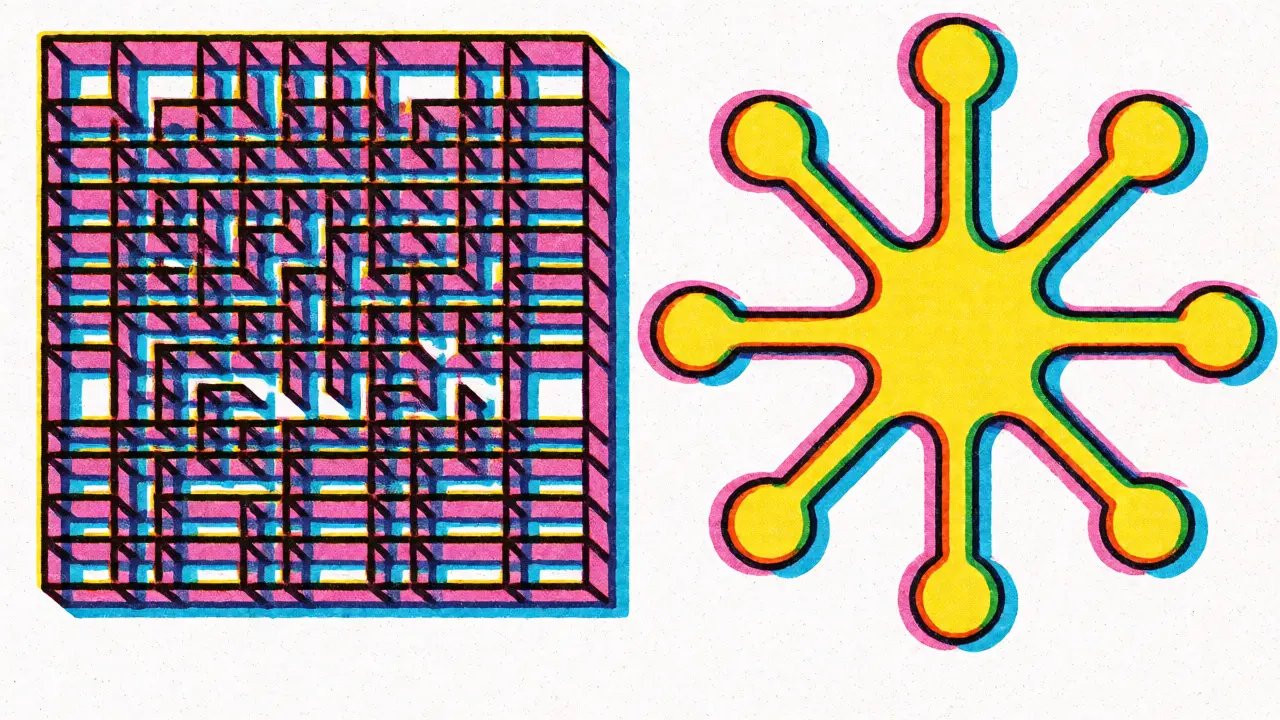
Поэтому в DWH чаще используют денормализованные схемы. Самая популярная - схема «Звезда». В центре находится факт (например, «Продажа»), а вокруг нее - денормализованные измерения (таблицы «Товар», «Дата», «Магазин»). В таблице «Товар» могут повторяться названия категорий для каждого товара. Да, это избыточность. Но зато запрос становится простым: берем факты, присоединяем одну широкую таблицу измерений, и результат готов.
| Характеристика | Операционная БД (OLTP) | Хранилище данных (OLAP) |
|---|---|---|
| Цель | Быстрая запись и обновление | Быстрое чтение больших объемов |
| Структура | Нормализованная (3НФ) | Денормализованная (Схема «Звезда») или частично нормализованная («Снежинка») |
| Дублирование | Минимальное | Допустимо ради скорости |
| Производительность | Высокая при простых операциях | Высокая при сложных агрегациях |
Компромисс: Схема «Снежинка»
Не всегда стоит идти в крайности. Полная денормализация занимает много места на диске. Если у вас гигантские объемы данных, это может ударить по бюджету. Тут на помощь приходит схема «Снежинка».
В схеме «Снежинка» измерения частично нормализованы. Возьмем пример с товаром. Вместо того чтобы хранить название категории и поставщика прямо в таблице «Товар» (как в «Звезде»), мы выносим их в отдельные маленькие таблицы «Категории» и «Поставщики». Таблица «Товар» ссылается на них через внешние ключи.
Это золотая середина. Вы экономите место, убирая явные дубли крупных текстовых полей, но сохраняете приемлемую скорость запросов, так как количество соединений остается небольшим. По данным аналитиков Gartner, около 78% успешных проектов используют гибридные подходы, комбинируя элементы этих схем в зависимости от типа данных.
Практические шаги для интеграции источников
Как же реализовать это на практике? Не пытайтесь спроектировать идеальную схему с первого раза. Начните с малого.
- Аудит источников: Составьте карту всех систем. Где живут данные? В каком формате? Как часто обновляются?
- Определение гранулярности: Решите, на каком уровне детализации вам нужны данные. Нужны ли вам продажи по каждому чеку или достаточно ежедневных итогов по магазинам? Чем мельче гранулярность, тем больше данных придется обрабатывать.
- Проектирование справочников: Создайте единые справочники клиентов, товаров и сотрудников. Это основа нормализации. Используйте алгоритмы нечеткого поиска (fuzzy matching), чтобы объединять похожие записи из разных источников.
- Разработка модели DWH: Выберите схему («Звезда» для старта, «Снежинка» для экономии ресурсов). Определите таблицы фактов и измерений.
- Настройка ETL: Напишите скрипты очистки и трансформации. Автоматизируйте проверку качества данных (Data Quality Checks). Например, проверяйте, что сумма продаж равна сумме позиций в чеке.
Помните: нормализация - это не разовое действие, а непрерывный процесс. Данные в источниках меняются, появляются новые атрибуты. Ваша архитектура должна быть гибкой.
Частые ошибки при сводке данных
Самая частая ошибка - игнорирование истории изменений. Что делать, если цена товара изменилась? В операционной базе старая запись перезаписывается. В хранилище данных нужно хранить историю (Slowly Changing Dimensions), чтобы вы могли построить график изменения цен во времени. Если вы просто перезапишете цену, потеряете возможность анализа трендов.
Вторая ошибка - недооценка сложности маппинга (сопоставления) полей. Когда вы соединяете данные из двух разных систем, понятия «клиент» могут означать разные вещи. В одной системе это физическое лицо, в другой - юридическое. Без четких правил маппинга ваши цифры будут бессмысленными.
Нужна ли нормализация в хранилище данных?
Да, но в меньшей степени, чем в операционных базах. Обычно применяют частичную нормализацию (схему «Снежинка») для справочников, чтобы избежать дублирования, но оставляют денормализацию для основных таблиц фактов и измерений ради скорости аналитических запросов.
Что такое ETL и зачем оно нужно?
ETL расшифровывается как Extract (извлечение), Transform (преобразование), Load (загрузка). Это процесс переноса данных из различных источников в хранилище. Этап трансформации критически важен, так как именно там данные очищаются, нормализуются и приводятся к единому стандарту.
Чем схема «Звезда» отличается от схемы «Снежинка»?
В схеме «Звезда» измерения полностью денормализованы (все атрибуты в одной таблице). В схеме «Снежинка» измерения частично нормализованы (атрибуты вынесены в дополнительные связанные таблицы). «Звезда» быстрее для запросов, «Снежинка» экономит место на диске.
Как бороться с дублями при интеграции источников?
Используйте уникальные идентификаторы (ID) и алгоритмы нечеткого сопоставления строк. На этапе ETL создавайте «золотые записи» (golden records) - консолидированные версии объектов, которые заменяют собой множество разрозненных записей из разных систем.
Стоит ли использовать облачные хранилища для малых компаний?
Да, облачные решения (BigQuery, Snowflake, ClickHouse Cloud) позволяют начать с небольших затрат и масштабироваться по мере роста данных. Они также предоставляют встроенные инструменты для автоматической оптимизации запросов, что снижает необходимость глубоких знаний в ручной настройке индексов.
Перспективы: Автоматизация нормализации
Рынок движется к тому, чтобы рутину взяли на себя машины. Современные платформы данных начинают использовать искусственный интеллект для анализа шаблонов запросов и автоматического предложения оптимальной структуры хранения. Вам больше не нужно гадать, какую схему выбрать. Система сама увидит, что вы часто фильтруете по региону, и предложит добавить индекс или денормализовать поле региона.
Но пока технологии развиваются, человеческий фактор остается решающим. Понимание принципов нормализации позволяет вам контролировать качество данных, а не слепо доверять «черному ящику». Начните с аудита своих источников, определите ключевые сущности вашего бизнеса и стройте хранилище вокруг них, а не наоборот.